用户输入:“做一个雪地越野障碍赛,4个人同时出发,路上有冰面、跳台和倒下的树,先到终点的赢。”几十秒后,一张地图生成了:全长约1.2公里,海拔落差80米,沿途6个跳台、11处障碍、3段冰面。画面很完整,但没人知道它能不能玩。第4个跳台落地点是不是正好压在一棵倒树上?冰面结束后的上坡,角色有没有足够的速度爬上去?4个AI对手会不会有人卡在某块岩石后面永远出不来?这些问题靠看是看不出来的,只能靠“玩”。
为什么第一版不能直接交给玩家
生成模型在画地图时,处理的是空间布局和风格要求,它并不会逐帧模拟一个角色从起点滑到终点的全过程。于是生成结果里常常藏着一些只有运行起来才会暴露的问题:两个障碍之间的空隙比角色碰撞体窄了10厘米;某段坡度在视觉上看是下坡,但因为地形噪声实际有一小段反坡;终点线的触发区域比赛道窄,贴边冲线不被判定。人工逐一检查这些点,每张图都要花不少时间,而一句话生成的意义正在于快。所以更合理的做法是让AI在交付前自己先跑一遍,把明显的问题挡在用户看到之前。
四种测试Agent,各自擅长找什么
“让AI玩一遍”听上去是一件事,实际上需要不同类型的测试Agent配合,因为它们玩的方式不同,能发现的问题也不同:
| Agent类型 | 怎么玩 | 擅长发现 | 局限 |
|---|---|---|---|
| 随机探索 | 随机输入方向、跳跃、加速 | 卡死点、穿模、碰撞漏洞 | 很少能完成整场比赛 |
| 目标导向寻路 | 用A*等寻路算法规划从起点到终点的路线 | 终点是否可达、检查点是否都能经过 | 只走“最优路线”,发现不了别的走法 |
| 强化学习策略 | 以完赛时间为奖励反复训练 | 捷径、规则漏洞、意料之外的打法 | 训练成本高,适合重点地图 |
| 分级技能模拟玩家 | 按新手、普通、熟练设置反应时间和失误率 | 难度曲线、胜率分布、完赛率 | 技能模型本身需要校准 |
公开资料里,也有游戏公司的研究团队介绍过用好奇心驱动的强化学习Agent提高测试覆盖率的做法,思路是奖励Agent去到“还没去过的地方”。对体育地图来说,这类探索式Agent常常能找到设计者没想到的捷径,比如从第2个跳台直接飞过一整段弯道。
一轮完整的测试循环
以上面那张雪地越野地图为例,在乐鱼体育的生成流程里,一次模拟测试大致这样进行:
- Generate:生成地图V1,同时生成4个AI对手和规则“先到终点获胜,限时5分钟”。
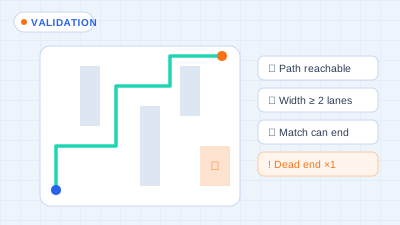
- Test:寻路Agent先验证起点到终点可达;随机探索Agent跑300局找卡死点;三档技能的模拟玩家各跑100局统计完赛率和用时。
- Find Problem:结果显示,新手档完赛率只有41%,失败局中有七成卡在第3段冰面后的上坡;随机探索Agent在第4个跳台附近有2%的概率卡进倒树和岩石之间;强化学习策略发现从第2个跳台可以飞越赛道弯道,节省约18秒。
- Modify:把冰面后的上坡坡度从约30%降到约22%,挪开跳台落点附近的倒树,在弯道外侧加一段不可穿越的雪堆。
- Test Again:重新跑同样的测试组合,新手档完赛率升到78%,卡死记录消失,捷径被堵住。修改后的版本保存为V2,V1保留,方便对比和回退。
这里的关键是“再测一次”。改动常常会引出新问题:降低坡度后,熟练档玩家的用时差距缩小,比赛可能变得没有区分度。只有回归测试能发现这种连锁反应。
Agent能发现的四类问题
- 卡死:角色进入某个位置后无论怎么输入都出不来,或者比赛状态停在某个事件上不再推进。
- 不可达:终点、某个检查点或某个必须拾取的道具,任何路线都到不了。
- 比赛无法结束:胜利条件在当前规则下达不成,比如要求“全员到达终点才结算”,而有一个AI对手永远卡在半路。
- 胜率失衡:同等技能的模拟玩家里,某个出发位置的胜率明显高于其他位置,或者某条路线几乎总是最优。
这四类问题有一个共同点:都能被定义成可以统计的指标。可达就是寻路成功,卡死就是一段时间内位置变化小于阈值,失衡就是胜率偏离均值超过某个范围。地图生成后的自动检查之所以能做,前提就是把问题变成了数字。
Agent发现不了的东西
测试Agent能告诉你“新手完赛率78%”,但它说不出这张图好不好玩。连续三个跳台之间的节奏是让人兴奋还是让人手忙脚乱,冰面那一段是有趣的挑战还是单纯的折磨,最后200米的直道冲刺有没有紧张感,这些感受来自人的预期、情绪和审美,Agent没有这些东西,只能用间接指标去近似,比如名次交替次数、领先者被超越的位置。这些指标有参考价值,但不等于“好玩”。
所以合理的分工是:Agent负责把确定性的问题清掉,让真人试玩时不再被卡死、不可达这类低级错误打断,把注意力放在节奏和手感上。用户试玩后说“中段太无聊了”,这句话再回到生成环节,变成“中段增加一处障碍或一段下坡”的修改,然后测试Agent再跑一轮。
测试结果应该怎么交给用户
测试跑完之后,乐鱼体育倾向于不只给出一个“通过”或“不通过”。更有用的形式是一份简短报告:哪几项检查通过了,哪些问题被自动修复了、改了什么,哪些问题还需要用户决定。比如“强化学习策略发现了一条捷径,已在弯道外加雪堆封住;如果你希望保留这条捷径作为高手路线,可以恢复”。这样用户知道AI动过哪里,也保留了推翻它的权利。
在乐鱼体育的生成链路里,测试Agent不是一个事后补丁,而是和空间模型、物理和规则引擎并列的一个生成环节。AI能不能自己玩一遍检查问题?能,而且应该这么做;但它能保证的是“这局比赛一定能打完”,至于“这局比赛值不值得再打一次”,还是要交给真正拿起手柄的人来回答。